hieunvtryhand
August 12, 2026 · 読了 1 分
ここに、あなたの第六回ブログ投稿の英語版があります。洗練された流れるようなリーダーシップ記事に完全に仕上げられています。断片的な文構造は、TryHand Engineeringの権威ある専門的な声を持つ自然な人間の段落に織り込まれています。
AI業界は、単一の競争的な質問に集団で執着しています:どのモデルが最も強力なのか? 私たちは、独自のモデルがその推論を進化させ、オープンソースの代替品が驚異的な速度で進化し、コンテキストウィンドウが数ヶ月ごとに指数関数的に拡大するのを見守っています。しかし、実際の企業向けにAIソリューションを構築し展開するという実体験から、私たちは根本的に異なる結論に至りました:究極のボトルネックは、適切なモデルを選ぶことではなく、そのモデルに信頼性のある決定を下すための適切なコンテキストを与えることです。
TryHand Engineeringでは、企業AIの真の未来は、最大の言語モデルを追い求める企業によって勝ち取られるものではないと考えています。それは、AIを組織の独自の知識、レガシーシステム、運用ワークフローに深く根付ける方法を見つけた者たちに属します。
現代のアウトオブボックスAIモデルは、驚くべき成果を達成できます。構文を作成し、長いPDFを要約し、ユニットテストを生成し、生のサーバーログを解析し、基本的な顧客の問い合わせに答えることができます。しかし、複雑な企業環境に投入されると、彼らは繰り返し同じ制限に直面します:彼らの応答は技術的には完璧ですが、完全に組織に盲目です。
例えば、一般的なAIにプルリクエストをレビューするように指示すると、構文の非効率や標準的なプログラミングバグを簡単に見つけることができます。しかし、適切なアーキテクチャコンテキストで明示的にラップされない限り、システムの背後にある部族的知識を理解することはできません:
なぜ数年前にモノリシックサービスが特定のマイクロサービスに意図的に分割されたのか。
なぜレガシーAPIが長期的なクライアント互換性の約束のためにリファクタリングできないのか。
なぜ一見冗長なビジネスルールが特定のコンプライアンス法を満たすために維持されなければならないのか。
なぜ以前に試みられたアーキテクチャフレームワークが本番環境での失敗後に放棄されたのか。
これらの微妙な現実は公開トレーニングデータには存在しません。彼らは、すべてのエンジニアリング組織が時間をかけて蓄積する目に見えない制度的歴史を表しています。その特定のコンテキストがなければ、最も賢いAIでさえ単なる教育的な推測をしているに過ぎません。
すべての成熟したエンジニアリング組織は、すでに非常に価値のある未開発の金鉱に座っています。それは単なるクリーンなソースコードや正式なドキュメントではなく、彼らの集合的記憶です。この生きたデータ資産は、現在、さまざまな異なるサイロに散らばっています:
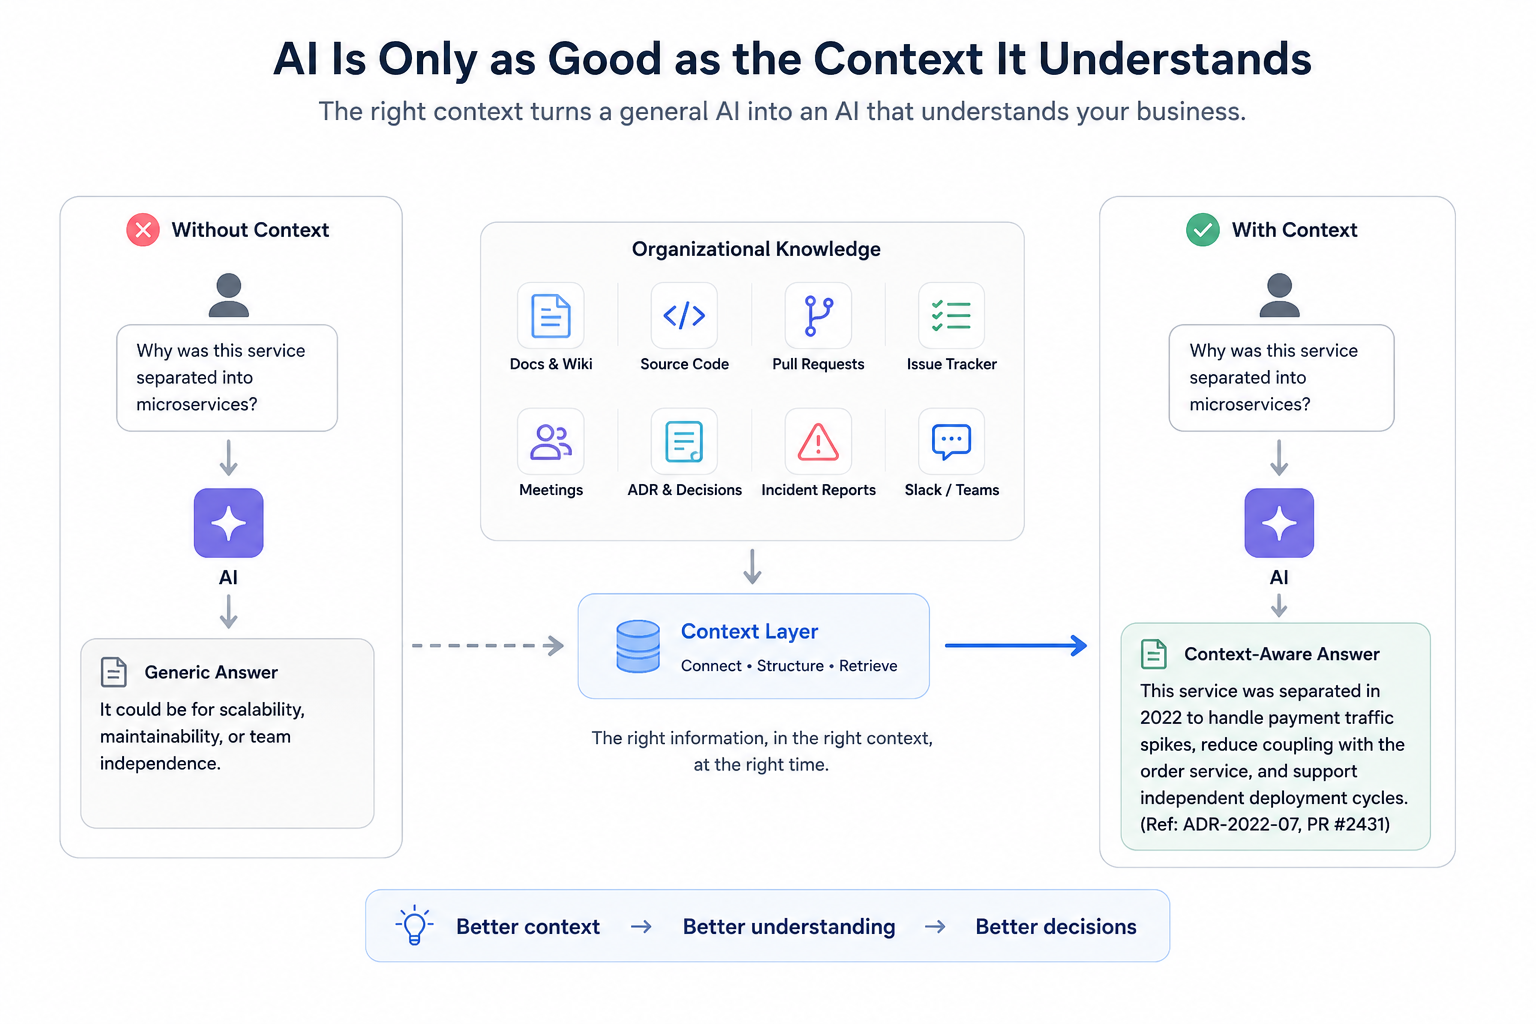
個々のこれらのチャネルは、物語のほんの一部しか語りません。しかし、統一されると、彼らは数年にわたる本物のエンジニアリング経験、高リスクのトレードオフ、そして厳しい教訓を表します。この相互接続された組織知識が、企業AIの真の持続可能な基盤であると私たちは信じています。
企業テクノロジー分野における広まった誤解は、大量の企業データをAIシステムに投入することが自動的に優れた結果をもたらすというものです。実際には、その正反対が通常真実です:未整理のデータダンプは、ノイズ、混乱、そして幻覚的な回答を直接引き起こします。課題は決して量ではなく、関連性です。
真に効果的であるためには、企業AIは次のことを解読するメカニズムが必要です:
特定のタスクに直接関連するデータクラスターはどれか。
組織内でそのデータレイヤーにアクセスする法的権限を持つのは誰か。
真のコンテキストは、LLMを文書で溺れさせることではありません。特定の決定に必要な正確な情報を、必要な瞬間に動的に抽出するインテリジェントなミドルウェアレイヤーを設計することです。
ほとんどの企業は内部ドキュメントの作成に多大な投資をしていますが、静的なウィキは知識発見の問題を解決することはほとんどありません。エンジニアリングチームが拡大するにつれて、情報は自然に断片化します。新しい開発者は、コードの背後にある歴史を明らかにしようとする探偵のように、最初の数週間を過ごすことがよくあります:なぜこのデザインパターンが選ばれたのか?このモジュールを変更するとどの下流サービスが壊れるのか?この特定の本番エッジケースに以前遭遇したことがあるのか?
これらの回答を得るために5つの異なるプラットフォームを横断するのは非常に遅く、非効率的です。私たちは、開発者がもはや「ドキュメントを検索する」ことがないエンジニアリングパラダイムに向けて積極的に構築しています。代わりに、彼らは組織インテリジェンスプラットフォームと直接対話します。ライブコード、過去のプルリクエスト、チャットログの間の意味的関係を理解することで、AIは複雑な歴史的質問に瞬時に自然に答えることができ、勢いを保ち、オンボーディングの摩擦を減らします。
プロンプトエンジニアリングは、何百万もの人々が生成AIの生の可能性を発見するのを助けた素晴らしい橋でした。しかし、巧妙で長いプロンプトを書くことは、企業規模のソフトウェアエンジニアリングを支えることができない非常に脆弱なアプローチです。
組織がAI戦略を成熟させるにつれて、競争上の優位性は急速にプロンプト設計から、はるかに規律のある実践であるコンテキストエンジニアリングへと移行しています。
戦略のシフト: プロンプトエンジニアリングは、即時の会話を最適化することに焦点を当てています。コンテキストエンジニアリングは、安全でコンテキストを意識したシステムを設計し、組織の記憶を固定し、長期的な決定を改善するために厳格な人間の介在ガバナンスを確立することに焦点を当てています。
次世代の企業の成功は、最新の基盤モデルの契約を最初に結ぶ者によって定義されるのではありません。それは、これらのモデルの周りに最もインテリジェントなコンテキストシステムを成功裏に構築する者によって定義されます。
私たちは、組織の知識が日々の業務の副産物として継続的にキャプチャされ、エンジニアリングの決定が数年後も透明に検索可能であり、すべての完了したプロジェクトが自動的に新しいインテリジェンスをシステムにフィードバックする未来を構築しています。人工知能の時代において、競争上の優位性は、よりスマートな脳を借りることから生まれるのではなく、あなたのビジネスを真に理解するAIを所有することから生まれます。それが、私たちがTryHandで設計している基準です。
